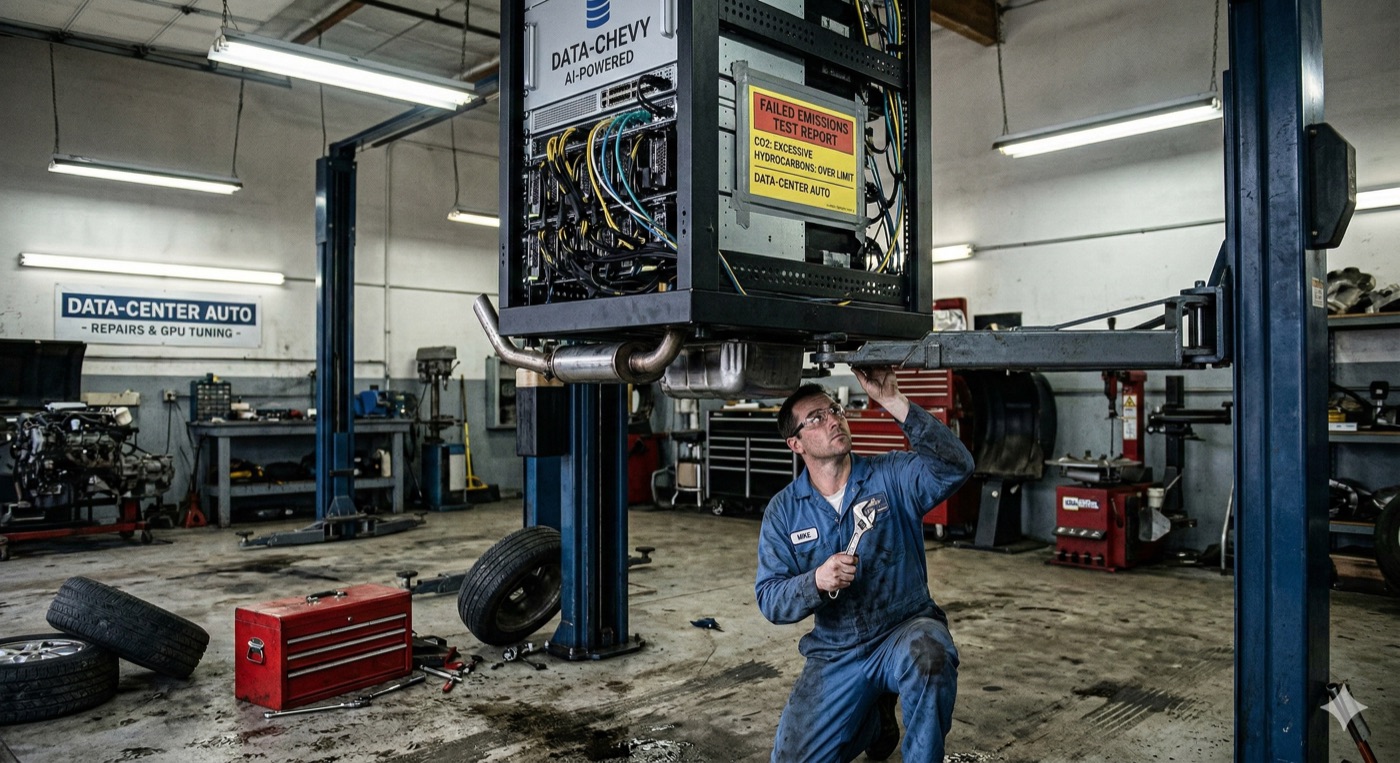
نحتاج إلى اختبار انبعاثات للذكاء الاصطناعي
نختبر السيارات للتأكد من انبعاثاتها قبل أن يُسمح لها بالسير على الطرق. ونصنّف الأجهزة المنزلية بحسب كفاءتها في استهلاك الطاقة. ونلصق على المباني ملصقات تخبرك بكمية الكهرباء التي تستهلكها في كل متر مربع.
أما وكلاء الذكاء الاصطناعي فلا يخضعون لشيء من هذا. لا أحد يسأل كم رمزًا أحرق النظام ليجيب عن سؤال جوابه نعم أو لا.
هدر غير مرئي
كل رمز يولّده نموذج لغوي كبير (LLM) يكلّف طاقة. كهرباء حقيقية، وتبريدًا حقيقيًا، واستهلاكًا حقيقيًا للعتاد. النموذج الذي يولّد 2,000 رمز من المقدمات والتحفظات والحشو ليقدّم 40 رمزًا من المعلومات الفعلية يصنع هدرًا. هدرًا ماديًا يمكن قياسه، وهدرًا بيئيًا.
لا أحد يقيسه. نحن في عصر «البنزين المحتوي على الرصاص» في الذكاء الاصطناعي. التقنية تعمل، والناس يحبونها، والآثار الجانبية بلا ثمن على الإطلاق.
كيف يبدو هذا
معيار موحّد لقياس الكفاءة، لا الدقة. إذا أعطينا مجموعة من المهام لها إجابات صحيحة معروفة، فكم رمزًا يستهلك النظام ليصل إليها؟
أربعة مقاييس:
1. نسبة كفاءة الرموز (TER)
TER = useful_output_tokens / total_tokens_generatedالنظام الذي يولّد 500 رمز لا يحمل منها معلومات فعلية سوى 80 تكون نسبته 0.16. هذا تصنيف F.
2. تكلفة إنجاز المهمة (TCC)
كم رمزًا (مدخلات ومخرجات) يستهلك الوكيل لإنجاز مهمة محددة بوضوح؟ لخّص هذا المستند. أصلح هذا الخطأ. أجب عن هذا السؤال. نظامان ينتجان الإجابة الصحيحة نفسها ليسا متساويين إذا كان أحدهما يستخدم رموزًا أكثر بعشر مرات.
3. عبء إعادة المحاولة والاستكشاف
الأنظمة الوكيلة هي الأسوأ في هذا. وكيل يجرّب 5 طرق خاطئة قبل أن يعثر على الصحيحة قد «ينجح»، لكنه يستهلك موارد تفوق 5 أضعاف ما يستهلكه وكيل يفكر فيصيب من المرة الأولى.
4. مؤشر هدر المحادثة
في المحادثات متعددة الأدوار، ما حصة ما يكرره الذكاء الاصطناعي من كلامه، أو يعيد به صياغة السؤال، أو يولّده من نص يعرفه المستخدم أصلًا؟ إنه ما يعادل محركًا يعمل واقفًا في الزحام. يحرق الوقود ولا يذهب إلى أي مكان.
الأرقام
لدى ChatGPT وحده 900 مليون مستخدم نشط أسبوعيًا. أضف Gemini وClaude وCopilot وغيرها، فيتجاوز العدد الحقيقي المليار بكثير. إذا كان كل تفاعل يكلّف في المتوسط 500 رمز لا حاجة إليها، فهذا يعني 500 مليار رمز مهدور كل أسبوع. وبحدود 0.001 كيلوواط ساعة لكل 1,000 رمز (تقدير متحفظ للاستدلال)، يصبح هذا 500,000 كيلوواط ساعة أسبوعيًا من الهدر الخالص. وهذا يكفي لتشغيل نحو 50,000 منزل.
سيضاعف الذكاء الاصطناعي الوكيل هذا بأضعاف كثيرة. أنظمة تعمل بذاتها، وتستدعي الأدوات، وتولّد وكلاء فرعيين، وتدور في حلقات من إعادة المحاولة. وكيل يعمل 10 دقائق ويحرق الرموز في حلقة يهدر أكثر من مالك. إنه يهدر الغلاف الجوي المشترك.
أين ينطبق التشبيه وأين ينكسر
تنتج السيارات ثاني أكسيد الكربون أثرًا جانبيًا لنقلك من أ إلى ب. وتنتج رموز الذكاء الاصطناعي ثاني أكسيد الكربون أثرًا جانبيًا للإجابة عن سؤالك. وفي الحالتين:
- يمكن إنجاز العمل المفيد نفسه بكميات متفاوتة جدًا من الهدر
- المستهلكون لا يرون الهدر وهو يحدث
- حوافز السوق وحدها لن تعالجه (النماذج الأكبر «أفضل»، كما كانت المحركات الأكبر «أفضل»)
- التنظيم والتصنيف غيّرا السلوك (معايير CAFE، وتصنيفات Energy Star)
وهنا يصبح الأمر مثيرًا: في السيارات لا تستطيع أن تجعل المحرك يفكّر أكثر فيما إذا كان يحتاج إلى حرق هذا الوقود. أما مع الذكاء الاصطناعي فتستطيع. يستطيع النظام أن يقرر هل يستحق الأمر ردًا من 2,000 رمز أم يكفي 50 رمزًا. الهدر في البرمجيات، لا في الفيزياء، وهذا يجعل المشكلة أيسر حلًا من انبعاثات السيارات في أي وقت مضى.
ما الذي سيتغير
تصبح الكفاءة محور منافسة: المعايير اليوم تكافئ الدقة. أما معيار الانبعاثات فيكافئ بلوغ الدقة نفسها بعدد أقل من الرموز. النموذج الذي يحقق 95% بـ200 رمز يُصنَّف أعلى من الذي يحقق 96% بـ2,000 رمز.
تتعرض أطر الوكلاء لضغط كي تتحسن: معماريات الوكلاء اليوم مسرفة على نحو صادم. حلقات إعادة المحاولة، وإعادة قراءة السياق كاملًا، واستدعاءات الأدوات المكررة. وتصنيف الانبعاثات سيدفع المطورين نحو تخطيط أذكى، وتخزين مؤقت أفضل، واستخدام أكفأ للأدوات.
يحصل المستخدمون على أساس للاختيار: يختار الناس أدوات الذكاء الاصطناعي بالانطباع والتسويق. وملصق الانبعاثات، مثل ملصق الكيلوواط ساعة على ثلاجتك، يتيح لهم أن يدخلوا الكفاءة في حسابهم. «هذا الوكيل مصنّف A: ينجز مهام البرمجة بعدد رموز أقل بثلاث مرات من المتوسط».
يعكس التسعير الواقع: تسعير الرموز اليوم سباق نحو القاع. وإذا أدخلنا الكلفة البيئية في الحساب، تصبح الأنظمة المسرفة باهظة، وتصبح الكفؤة رخيصة.
من يبني هذا
لا ينبغي أن تملكه شركة واحدة، وأقل من ذلك الشركات التي تبيع الرموز. إنه يحتاج إلى:
- جهة مستقلة (مثل EPA، أو نظام ملصقات الطاقة في الاتحاد الأوروبي) تحدد مهام المعيار وطريقة التقييم
- مجموعات اختبار موحّدة: من 100 إلى 500 مهمة متنوعة بميزانيات رموز مثلى معروفة، في البرمجة والكتابة والاستدلال وسير العمل الوكيل
- إبلاغ شفاف: ينشر المزوّدون درجات الانبعاثات إلى جانب معايير القدرات
- تصنيفات متدرجة: من A إلى F، أو نجوم، أو أي صيغة تجعلها مقروءة لغير التقنيين
يتحرك الاتحاد الأوروبي في هذا الاتجاه بالفعل عبر أحكام الاستدامة في قانون الذكاء الاصطناعي. لكن «أبلغ عن استهلاكك للطاقة» عبارة فضفاضة جدًا. نحتاج إلى مقياس كفاءة لكل مهمة، يتيح لك المقارنة بين الأنظمة مباشرة.
وكيلان، ومهمة واحدة
المهمة نفسها: «اقرأ هذا الملف من 200 سطر وأخبرني إن كانت فيه ثغرة حقن SQL».
الوكيل A يقرأ الملف ويرد في 120 رمزًا:
«نعم. السطر 47 يمرر
user_inputمباشرة إلى استعلام SQL مبني بسلسلة f-string دون معاملات. استخدم استعلامات ذات معاملات بدلًا من ذلك.»
الوكيل B يقرأ الملف، ثم يعيد قراءته، ثم يولّد 1,500 رمز: ملخصًا لما هو حقن SQL، وتاريخًا لقائمة OWASP Top 10، وثلاث استراتيجيات للمعالجة مع أمثلة شيفرة، وملاحظات عن التفاعل مع ORM، وإخلاء مسؤولية عن اكتمال الإجابة.
كلاهما صحيح. وقد يحصل B على درجة أعلى في المعايير الحالية لأنه «شامل». لكنه حرق 12 ضعف الرموز، و90% من مخرجاته حشو لم يطلبه أحد.
الوكيل A ينجح في اختبار الانبعاثات. والوكيل B سيارة شرهة للوقود.
خلاصة
لا نسمح للسيارات بالسير على الطرق قبل اختبار انبعاثاتها. وينبغي ألا نسمح لوكلاء الذكاء الاصطناعي بدخول الإنتاج قبل اختبار انبعاثاتهم.
ونحن نوسّع هذه الأنظمة لتصل إلى مليارات المستخدمين وإلى التشغيل المستقل، فربما علينا أن نتبيّن هل نبني المعادل الحسابي لسيارة عضلات من السبعينيات: مبهرة، وقوية، ومسرفة إلى حد الكارثة.
الرمز هو الغالون الجديد.
يسعدني أن أسمع ممن يعمل على استدامة الذكاء الاصطناعي، أو الحوسبة الخضراء، أو تحسين النماذج. كيف كنت ستصمم المعيار؟