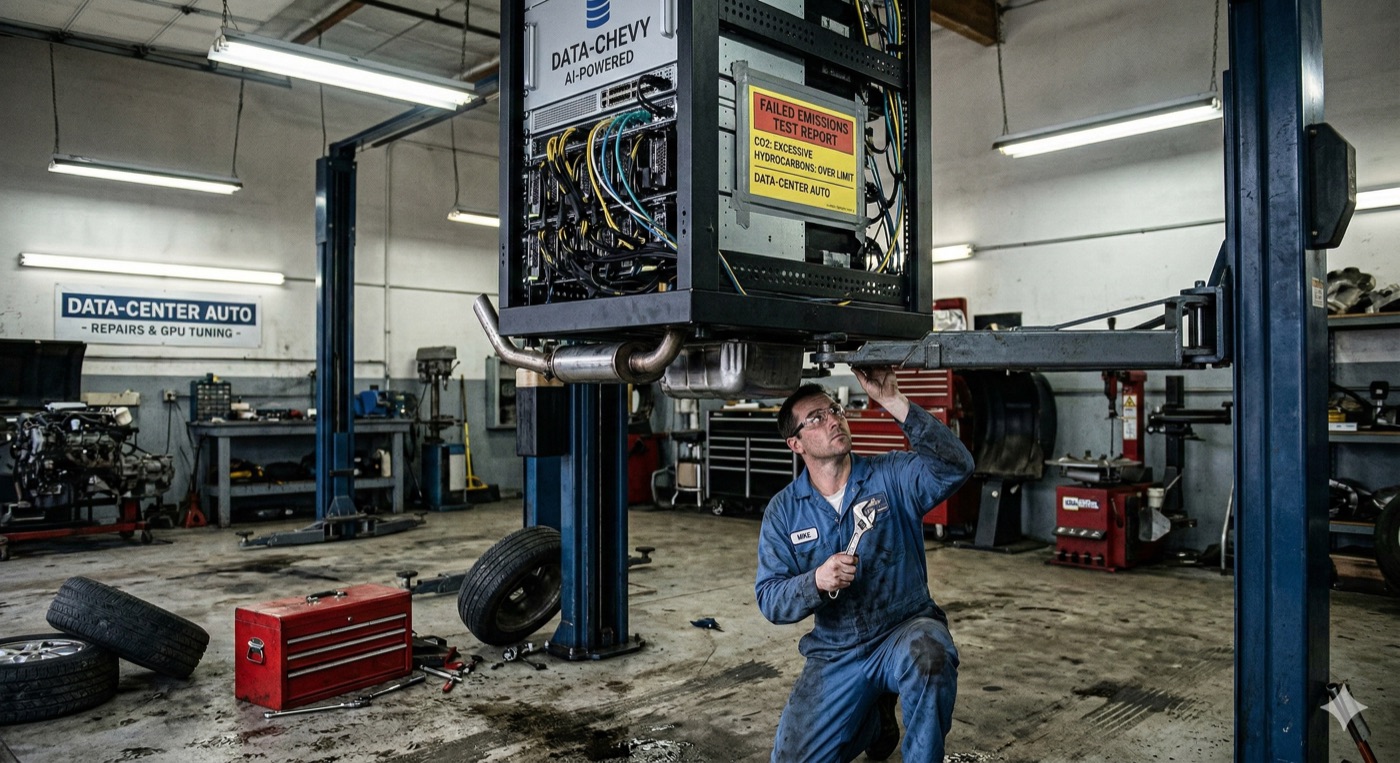
Necesitamos una prueba de emisiones para la IA
Probamos las emisiones de los coches antes de dejarlos circular. Calificamos los electrodomésticos por su eficiencia energética. Pegamos etiquetas en los edificios que dicen cuánta energía consumen por metro cuadrado.
Los agentes de IA no reciben nada de esto. Nadie pregunta cuántos tokens quemó un sistema para responder una pregunta de sí o no.
Desperdicio invisible
Cada token que genera un modelo de lenguaje grande (LLM) cuesta energía. Electricidad real, refrigeración real, desgaste real del hardware. Un modelo que genera 2.000 tokens de preámbulo, advertencias y relleno para entregar 40 tokens de información útil está produciendo desperdicio. Desperdicio físico, medible, ambiental.
Nadie lo mide. Estamos en la era de la «gasolina con plomo» de la IA. La tecnología funciona, a la gente le encanta y las externalidades no tienen ningún precio.
Cómo sería
Un punto de referencia estandarizado para la eficiencia, no para la precisión. Dado un conjunto de tareas con respuestas correctas conocidas, ¿cuántos tokens consume el sistema para llegar a ellas?
Cuatro métricas:
1. Razón de eficiencia de tokens (TER)
TER = useful_output_tokens / total_tokens_generatedUn sistema que genera 500 tokens pero solo 80 llevan información útil tiene un TER de 0,16. Eso es una calificación F.
2. Costo de completar una tarea (TCC)
¿Cuántos tokens (de entrada y de salida) consume el agente para completar una tarea bien definida? Resume este documento. Corrige este error. Responde esta pregunta. Dos sistemas que producen la respuesta correcta no son iguales si uno usa 10 veces más tokens.
3. Sobrecarga de reintentos y exploración
Los sistemas agénticos son los peores infractores. Un agente que prueba 5 enfoques equivocados antes de dar con el correcto quizá «funcione», pero consume 5 veces más recursos que uno que razona bien a la primera.
4. Índice de desperdicio conversacional
En las interacciones de varios turnos, ¿qué parte de la conversación es la IA repitiéndose, reformulando la pregunta o generando texto que el usuario ya sabe? El equivalente a un motor al ralentí en un atasco. Quema combustible sin ir a ninguna parte.
Los números
Solo ChatGPT tiene 900 millones de usuarios activos semanales. Suma Gemini, Claude, Copilot y el resto, y la cifra real supera con mucho los mil millones. Si cada interacción cuesta en promedio 500 tokens innecesarios, son 500.000 millones de tokens desperdiciados por semana. A unos 0,001 kWh por cada 1.000 tokens (una estimación conservadora para la inferencia), son 500.000 kWh por semana de puro desperdicio. Suficiente para abastecer a unas 50.000 viviendas.
La IA agéntica multiplicará esto por órdenes de magnitud. Sistemas que funcionan de forma autónoma, llaman a herramientas, lanzan subagentes y se repiten en bucles de reintentos. Un agente que corre durante 10 minutos quemando tokens en un bucle desperdicia más que tu dinero. Desperdicia la atmósfera compartida.
Dónde se sostiene la analogía y dónde se rompe
Los coches producen CO2 como subproducto de llevarte de A a B. Los tokens de IA producen CO2 como subproducto de responder tu pregunta. En ambos casos:
- El trabajo útil se puede hacer con cantidades de desperdicio muy distintas
- Los consumidores no ven cómo se produce el desperdicio
- Los incentivos del mercado por sí solos no lo arreglarán (los modelos más grandes son «mejores», igual que los motores más grandes eran «mejores»)
- La regulación y el etiquetado cambiaron el comportamiento (las normas CAFE, las calificaciones Energy Star)
Aquí viene lo interesante: con los coches no puedes hacer que el motor piense más si necesita quemar ese combustible. Con la IA, sí. El sistema puede razonar si una respuesta de 2.000 tokens está justificada o si bastarían 50. El desperdicio está en el software, no en la física, lo que en realidad hace de este un problema más resoluble de lo que fueron nunca las emisiones de los automóviles.
Qué cambiaría
La eficiencia se vuelve un eje de competencia: Ahora mismo, los puntos de referencia premian la precisión. Uno de emisiones premiaría lograr la misma precisión con menos tokens. El modelo que obtiene un 95 % con 200 tokens se califica más alto que el que obtiene un 96 % con 2.000 tokens.
Los marcos de agentes reciben presión para optimizar: Las arquitecturas de agentes de hoy son sorprendentemente derrochadoras. Bucles de reintentos, relecturas del contexto completo, llamadas redundantes a herramientas. Una calificación de emisiones empujaría a los desarrolladores hacia una planificación más inteligente, mejor almacenamiento en caché y un uso más eficiente de las herramientas.
Los usuarios obtienen una base para elegir: La gente elige herramientas de IA por sensaciones y por marketing. Una etiqueta de emisiones, como la de kWh de tu nevera, les permite tener en cuenta la eficiencia. «Este agente tiene calificación A: completa tareas de programación con 3 veces menos tokens que el promedio.»
Los precios reflejan la realidad: El precio de los tokens hoy es una carrera hacia el fondo. Si internalizamos el costo ambiental, los sistemas derrochadores se vuelven caros y los eficientes, baratos.
Quién lo construye
Ninguna empresa debería ser dueña de esto, y menos las que venden los tokens. Hace falta:
- Un organismo independiente (como la EPA o el sistema de etiquetado energético de la UE) que defina las tareas del punto de referencia y la puntuación
- Conjuntos de pruebas estandarizados: de 100 a 500 tareas diversas con presupuestos óptimos de tokens conocidos, en programación, escritura, razonamiento y flujos de trabajo agénticos
- Informes transparentes: los proveedores publican sus puntuaciones de emisiones junto a los puntos de referencia de capacidad
- Calificaciones por niveles: de la A a la F, estrellas, lo que sea que resulte legible para usuarios no técnicos
La UE ya se mueve en esta dirección con las disposiciones de sostenibilidad de la Ley de IA. Pero «informa de tu consumo de energía» es demasiado vago. Necesitamos una métrica de eficiencia por tarea que permita comparar sistemas directamente.
Dos agentes, una tarea
La misma tarea: «Lee este archivo de 200 líneas y dime si hay una vulnerabilidad de inyección SQL.»
El agente A lee el archivo y responde en 120 tokens:
«Sí. La línea 47 pasa
user_inputdirectamente a una consulta SQL construida con una f-string sin parametrizar. Usa consultas parametrizadas en su lugar.»
El agente B lee el archivo, lo vuelve a leer y luego genera 1.500 tokens: un resumen de qué es la inyección SQL, una historia del OWASP Top 10, tres estrategias de corrección con ejemplos de código, notas sobre las interacciones con los ORM y un aviso sobre lo completo de la respuesta.
Ambos aciertan. Puede que B incluso puntúe más alto en los puntos de referencia actuales por ser «minucioso». Pero quemó 12 veces más tokens, y el 90 % de su salida fue relleno que nadie pidió.
El agente A pasa la prueba de emisiones. El agente B es un coche que bebe gasolina sin control.
Entonces
No dejamos que los coches circulen sin probar sus emisiones. No deberíamos dejar que los agentes de IA entren en producción sin probar las suyas.
A medida que escalamos estos sistemas a miles de millones de usuarios y a la operación autónoma, quizá deberíamos averiguar si estamos construyendo el equivalente computacional de un muscle car de los años setenta: impresionante, potente y catastróficamente derrochador.
El token es el nuevo galón.
Me gustaría saber de cualquiera que trabaje en sostenibilidad de la IA, computación verde u optimización de modelos. ¿Cómo diseñarías el punto de referencia?